
Una página huérfana puede seguir publicada, aparecer en un sitemap e incluso recibir impresiones desde Google. El problema es que no existe una ruta de enlaces internos para llegar a ella desde el resto del sitio. Si solo rastreás la web desde la home, esa URL queda fuera del mapa.
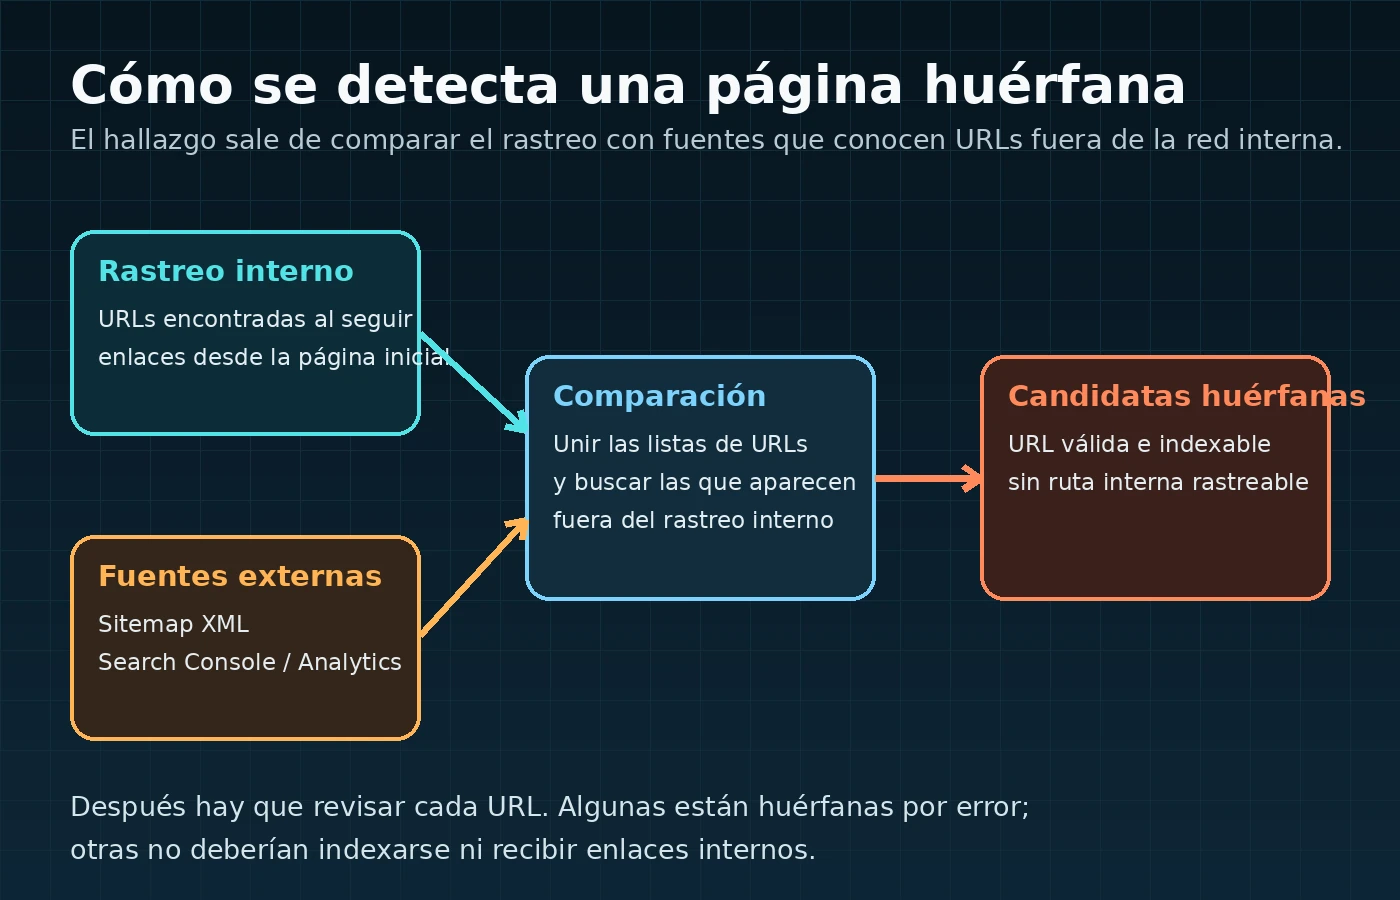
Por eso Screaming Frog no puede detectar páginas huérfanas con un rastreo aislado. Hay que comparar las URLs enlazadas con otras fuentes: el sitemap XML, Google Search Console y, si está disponible, Google Analytics. La diferencia entre esas listas revela las candidatas que requieren revisión.
Qué es una página huérfana
Una página es huérfana cuando no tiene una ruta interna rastreable desde el punto de inicio del crawl, normalmente la página principal. Puede recibir enlaces desde otras páginas huérfanas y seguir estando aislada de la estructura principal. Esta es también la definición operativa que usa Screaming Frog en su documentación.
No conviene confundirla con una URL sin enlaces externos ni con una página ubicada a mucha profundidad. Una URL puede estar a cinco clics de la home y no ser huérfana. También puede tener backlinks y seguir sin un solo enlace interno.
Por qué un crawl común no alcanza
Un crawler descubre URLs siguiendo enlaces. Si una página no está enlazada, el robot no tiene por dónde llegar. Pedirle a Screaming Frog que encuentre páginas huérfanas sin darle fuentes adicionales es una contradicción: la herramienta solo puede comparar aquello que conoce.
Las fuentes complementarias cumplen funciones distintas:
- El sitemap XML aporta las URLs que el sitio declara como relevantes para los buscadores.
- Search Console aporta páginas que registraron actividad o fueron conocidas por Google.
- Analytics puede revelar páginas visitadas aunque ya no formen parte del enlazado interno.
Google también recomienda que cada página importante reciba al menos un enlace desde otra página del sitio. Un sitemap ayuda al descubrimiento, pero no reemplaza una arquitectura interna comprensible ni garantiza que Google rastree o indexe cada URL declarada.
Cómo encontrar páginas huérfanas con Screaming Frog
1. Configurá el rastreo del sitemap
En Screaming Frog, abrí Configuration > Spider > Crawl y activá el rastreo de sitemaps XML enlazados. Podés permitir que la herramienta los descubra desde robots.txt o indicar la URL del sitemap.
Este paso incorpora URLs que el CMS incluyó en el sitemap pero que el crawler no habría encontrado siguiendo enlaces internos. Si administrás WordPress, revisá antes que el sitemap no contenga páginas con noindex, redirecciones, errores o contenido que ya no debería estar publicado.
2. Conectá Google Search Console
Andá a Configuration > API Access > Google Search Console, elegí la propiedad correcta y definí un período suficiente para recoger actividad real. La documentación de Screaming Frog sugiere analizar al menos un mes.
Activá la opción para rastrear las URLs nuevas descubiertas en Search Console. Si no lo hacés, las URLs pueden aparecer en el informe de huérfanas, pero no se agregarán a la cola de rastreo ni tendrán todos los datos técnicos del crawl.
3. Sumá Google Analytics si aporta cobertura
La integración con Analytics se configura desde Configuration > API Access. Sirve para encontrar URLs que recibieron sesiones durante el período seleccionado y ya no están enlazadas. No es imprescindible para todos los sitios: si la medición cambió, el histórico es corto o hay muchas URLs con parámetros, puede introducir ruido.
Acá vale ser bastante desconfiado. Una URL registrada por Analytics no es automáticamente una página indexable que merezca enlaces. Puede ser una variante con parámetros, una pantalla privada, una página de campaña vencida o una URL que debería redirigir.
4. Ejecutá el crawl y el análisis posterior
Iniciá el rastreo desde la URL principal y esperá a que termine. Después ejecutá Crawl Analysis > Start. Este segundo paso completa los filtros de URLs huérfanas para Sitemaps, Analytics y Search Console.
Cuando el análisis llega al 100%, podés revisar cada fuente por separado o exportar el informe combinado desde Reports > Orphan Pages. La columna de origen permite saber si Screaming Frog descubrió cada URL mediante sitemap, Search Console o Analytics.
Cómo interpretar el informe sin generar trabajo inútil
El informe no es una lista de páginas a enlazar. Es una lista de URLs para diagnosticar. Antes de tocar el sitio, clasificá cada caso.
| Situación | Qué revisar | Respuesta posible |
|---|---|---|
| Contenido útil y vigente | Intención, calidad, indexabilidad y ubicación en la arquitectura | Agregar enlaces internos contextuales y, si corresponde, incluirlo en navegación o hubs |
| URL antigua con reemplazo | Contenido equivalente, señales y destino correcto | Recomendar consolidación o redirección para revisión; no improvisarla durante la auditoría |
| Página válida pero no indexable | noindex, canonical, permisos y propósito | Mantenerla fuera del enlazado SEO si el aislamiento es intencional |
| Parámetros, filtros o sesiones | Canonical, robots, navegación facetada y utilidad | Corregir la generación o excluirla del análisis |
| Error 404 o 5XX | Enlaces históricos, sitemap y tráfico | Corregir el error o retirar la URL del sitemap |
La peor corrección es enlazar todas las URLs del informe para que deje de marcar errores. Eso mejora el reporte y puede empeorar el sitio. Una página vencida, duplicada o sin valor no gana utilidad porque le agreguemos un enlace desde el footer.
Errores frecuentes al buscar contenido huérfano
Tomar el sitemap como inventario perfecto
El sitemap suele arrastrar URLs que ya no deberían estar allí y puede omitir otras por una configuración incorrecta. Contrastalo con el inventario del CMS y con el estado HTTP. Si necesitás revisar el impacto de errores técnicos, esta guía sobre errores 404 y 5XX explica cómo separar una URL rota de una página simplemente aislada.
Mirar solo el código 200
Una respuesta correcta no dice si la página es útil, única o indexable. Revisá también canonical, meta robots, contenido, fecha, tráfico y coincidencia con otras URLs. Para auditorías grandes, conviene sumar el análisis a una revisión de rastreo e indexación.
Forzar enlaces desde cualquier página
El enlace tiene que ayudar al lector y encajar en la arquitectura. Priorizá páginas temáticamente cercanas, hubs, categorías y contenidos con una relación clara. Evitá anchors repetidos y bloques genéricos agregados solo para modificar una métrica.
Confundir huérfana con poco enlazada
Una página con un único enlace interno no es huérfana, aunque puede estar mal integrada. Screaming Frog permite revisar profundidad y cantidad de inlinks para detectar ese problema distinto. Conviene separarlo: primero encontrá URLs sin ruta interna; después evaluá cuáles reciben enlaces insuficientes o débiles.
Checklist de validación antes de corregir
- Confirmá que la URL responde con el estado esperado.
- Revisá si puede indexarse y si su canonical apunta al destino correcto.
- Compará la intención con páginas publicadas para evitar duplicación.
- Verificá que el contenido siga vigente y tenga un propietario editorial claro.
- Decidí si merece enlaces, una actualización, una consolidación o quedar fuera del índice.
- Si agregás enlaces internos, comprobá luego que el crawler pueda llegar a la URL desde la home.
Una auditoría de páginas huérfanas termina cuando cada URL tiene una decisión, no cuando el informe queda vacío. Algunas necesitan volver a la arquitectura. Otras exponen basura histórica que conviene retirar del sitemap o llevar a una revisión de consolidación. La diferencia surge del propósito de la página, no de la etiqueta que muestra la herramienta.