
El problema SEO de un marketplace C2C no es publicar más avisos, sino decidir cuáles merecen convertirse en páginas de búsqueda. Cada alta de usuario puede generar una URL; cada filtro puede multiplicarla; cada baja puede dejar una página vacía. Si esas decisiones quedan libradas al frontend, Googlebot termina recorriendo combinaciones sin valor mientras las publicaciones útiles dependen de un buscador interno o de JavaScript para ser descubiertas.
Esta guía propone un sistema técnico para marketplaces entre particulares: controlar la indexación de publicaciones generadas por usuarios, convertir algunas facetas en landings estables y evitar que el spam, los duplicados y los avisos vencidos degraden el conjunto. No es una guía general sobre modelos comerciales: para esa definición está la comparación entre B2B, B2C, C2C y C2B.
Qué hace diferente al SEO de un marketplace C2C
En un ecommerce tradicional, el equipo controla el catálogo. En un C2C, la oferta nace de usuarios con criterios, vocabulario y calidad visual desparejos. Dos personas pueden publicar el mismo modelo como “bici rodado 29”, “bicicleta MTB 29” y “mountain bike casi nueva”. También pueden duplicar un aviso, omitir la ubicación, dejar un precio irreal o insertar enlaces promocionales.
La plataforma, por lo tanto, tiene que resolver tres capas antes de pensar en rankings:
- Descubrimiento: que cada publicación aprobada y útil sea accesible mediante enlaces HTML rastreables, no solamente desde la búsqueda interna.
- Selección: que no toda URL creada por usuarios o filtros entre automáticamente al índice.
- Mantenimiento: que el estado SEO cambie cuando un aviso se vende, vence, se modera, se duplica o se elimina.
Google explica que la navegación y los enlaces entre páginas influyen en cómo entiende la estructura de un sitio, y recomienda enlazar categorías, subcategorías y páginas de producto mediante enlaces rastreables. También advierte que Googlebot normalmente no completa formularios de búsqueda interna. En un marketplace, el sitemap ayuda al descubrimiento, pero no reemplaza una arquitectura navegable.
Una política de indexación para publicaciones de usuarios
No conviene usar una regla binaria del tipo “todo aviso se indexa” o “ningún aviso se indexa”. La decisión debería depender del estado del aviso y de si la página ofrece una respuesta independiente para una búsqueda. La siguiente matriz es un punto de partida; los umbrales concretos deben validarse con el inventario, la moderación y los datos de Search Console de cada plataforma.
| Estado de la publicación | Tratamiento inicial | Condición para cambiarlo |
|---|---|---|
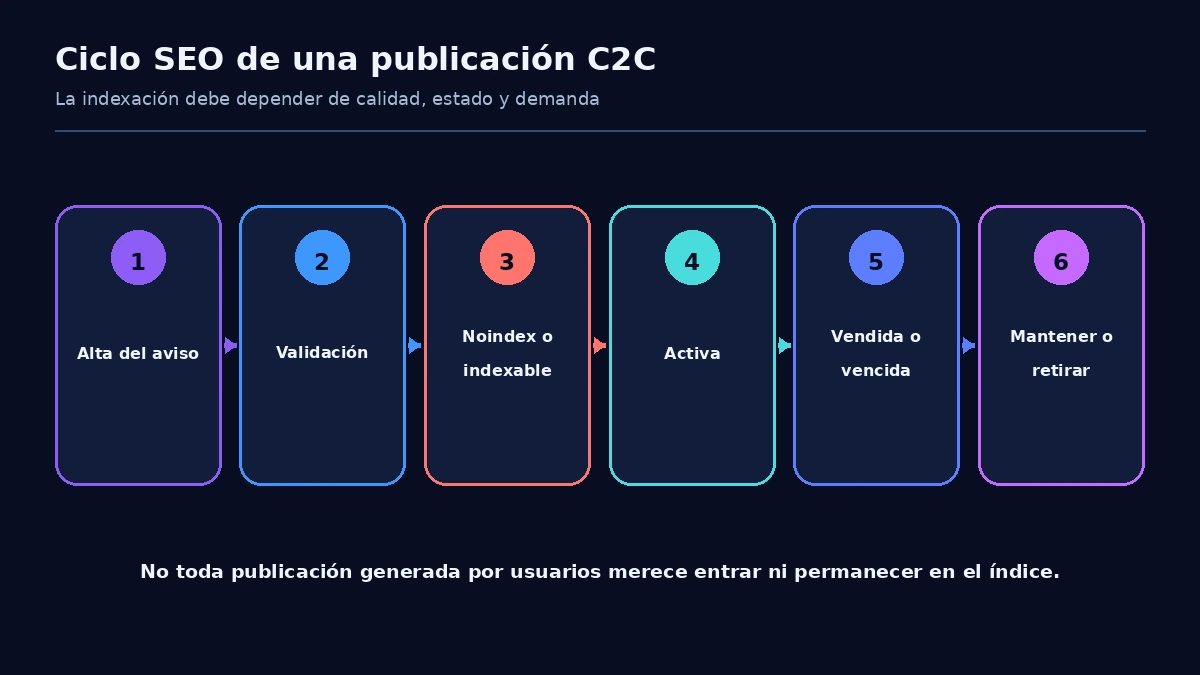
| Nueva o pendiente de moderación | noindex, accesible para revisión | Publicación aprobada, completa y disponible |
| Activa y con información suficiente | Indexable, canonical autorreferente y en sitemap | Mientras conserve valor, disponibilidad y una URL estable |
| Activa pero pobre, duplicada o sospechosa | noindex o rechazo editorial | Solo tras corregir los problemas que motivaron la exclusión |
| Vendida o vencida | Evaluación por utilidad residual | Mantener si conserva información útil; retirar si quedó vacía o engañosa |
| Eliminada sin reemplazo equivalente | 404 o 410 | No redirigir de manera automática a una categoría genérica |
| Duplicado con equivalente claro | Consolidar en la URL principal | Redirección solo cuando el destino satisface realmente la misma necesidad |
La URL indexable necesita contenido mínimo, pero no un conteo de palabras
Google no publica un mínimo de palabras para indexar una página. En vez de inventar uno, conviene definir controles ligados a la utilidad del aviso:
- título que identifique el objeto o servicio sin repetir cadenas promocionales;
- categoría y atributos obligatorios coherentes;
- descripción propia que permita distinguir esa oferta;
- precio o condición comercial cuando corresponda;
- ubicación con la granularidad adecuada para buscar sin exponer datos sensibles;
- imágenes válidas y estado de disponibilidad;
- señales de moderación, identidad o reputación relevantes para la transacción;
- ausencia de duplicados, malware, datos prohibidos y patrones de spam.
Esto puede implementarse como una puntuación editorial interna, pero no debería presentarse como un “factor de ranking de Google”. Su función es operativa: impedir que la plataforma solicite indexación para páginas que todavía no cumplen su propio estándar.
noindex no equivale a bloquear el rastreo
Una URL con noindex tiene que poder ser rastreada para que Google lea la directiva. Si al mismo tiempo se bloquea en robots.txt, Google puede no ver ese noindex. Por eso las publicaciones en moderación pueden mantenerse fuera de los resultados con una metaetiqueta o cabecera X-Robots-Tag, sin incluirlas en el sitemap y sin depender de ellas para descubrir otras páginas.
Google sugiere una aplicación especialmente pertinente para plataformas: agregar noindex al contenido de usuarios nuevos sin reputación y permitir la indexación cuando ese usuario gana confianza. No es necesario copiar esa política literalmente, pero sí integrar reputación, moderación y SEO en el mismo flujo.
Calidad y prevención de spam en contenido generado por usuarios
La plantilla no corrige por sí sola una base de avisos de baja calidad. El formulario de publicación tiene que producir datos reutilizables: un campo libre para la descripción y campos estructurados para categoría, marca, modelo, condición, ubicación, precio y disponibilidad. Esa separación permite construir títulos legibles, filtros consistentes, snippets correctos y controles automáticos sin reescribir lo que dijo el vendedor.
Controles antes y después de publicar
- Validar al crear: campos obligatorios, formatos, categorías permitidas, imágenes y términos prohibidos.
- Detectar duplicados: comparar identificadores, texto, imágenes, usuario y atributos; no confiar solo en la coincidencia del título.
- Aplicar moderación proporcional: revisión manual para patrones sospechosos, categorías sensibles o cuentas sin historial.
- Calificar enlaces externos: usar
rel="ugc"onofollowen enlaces incorporados por usuarios no confiables. - Permitir reportes: fraude, producto prohibido, suplantación, duplicado o información engañosa necesitan un circuito de baja verificable.
- Revisar en continuidad: los avisos pueden cambiar después de indexarse; hay que volver a validar ediciones y monitorear patrones de abuso.
La documentación de Google sobre spam generado por usuarios recomienda comunicar una política de abuso, identificar cuentas sospechosas, moderar interacciones y monitorear la plataforma. La consecuencia SEO es directa: la aprobación para indexar debe ser reversible. Si un aviso aprobado se transforma en spam, hay que retirarlo del sitemap, aplicar la respuesta correspondiente y no esperar a una auditoría trimestral.
Facetas: cuáles pueden ser landings y cuáles deben quedar como filtros
Una navegación facetada permite combinar categoría, ubicación, marca, condición, precio, entrega y otros atributos. Es útil para comprar, pero una implementación basada en parámetros puede generar un espacio casi infinito de URLs. Google señala dos efectos: rastreo excesivo y descubrimiento más lento de páginas útiles.
La solución no es indexar todas las combinaciones ni bloquearlas todas. Conviene separar dos conjuntos:
- Landings de demanda: combinaciones seleccionadas porque representan una intención estable, tienen oferta suficiente y ofrecen una experiencia distinta. Por ejemplo, una categoría y una ciudad pueden justificar una URL si ambas dimensiones son relevantes para la búsqueda.
- Estados de interfaz: ordenamientos, rangos arbitrarios, filtros acumulativos, parámetros de sesión y combinaciones sin demanda propia. Sirven al usuario, pero no necesitan convertirse en resultados orgánicos.
Criterios para promover una faceta a landing indexable
Una combinación debería superar una revisión explícita:
- existe una intención diferenciada, no apenas otra forma de ordenar la misma lista;
- hay inventario suficiente y razonablemente estable;
- la URL es permanente, descriptiva y usa siempre el mismo orden de filtros;
- el title, la introducción y los enlaces responden a esa combinación sin texto automático vacío;
- tiene canonical autorreferente y es accesible desde la navegación o enlaces contextuales;
- si queda sin resultados, la respuesta técnica está definida y no muestra una falsa página exitosa.
No hace falta fijar una cantidad universal de avisos. Una categoría de objetos coleccionables puede ser útil con menos oferta que una categoría masiva. La regla debe combinar demanda, recurrencia, variedad y riesgo de quedar vacía.
Cómo controlar las facetas que no se indexarán
Si una faceta no tiene valor en Search, evitá enlazar cada combinación como una URL rastreable. Cuando el objetivo es reducir el rastreo de espacios de parámetros, robots.txt puede bloquear patrones estables. Google advierte que usar solamente rel="canonical" o nofollow suele ser menos efectivo a largo plazo para controlar el rastreo facetado.
En cambio, si necesitás que Google acceda a una URL para procesar un noindex, no la bloquees antes en robots.txt. Son controles distintos:
| Objetivo | Mecanismo principal | Error a evitar |
|---|---|---|
| Evitar que una página aparezca en resultados | noindex, permitiendo el rastreo | Bloquearla en robots antes de que Google lea la directiva |
| Reducir rastreo de combinaciones sin valor | Reglas de robots.txt para patrones probados | Bloquear por accidente landings o publicaciones válidas |
| Consolidar duplicados o variantes equivalentes | rel="canonical" y señales coherentes | Canonizar páginas que responden a intenciones distintas |
| Eliminar combinaciones vacías o imposibles | 404 | Devolver 200 con “sin resultados” y crear un soft 404 |
La canonical es una señal, no una orden. Además, canonizar miles de facetas a la categoría madre no evita necesariamente que Googlebot las rastree. Primero hay que controlar cómo se generan y enlazan las URLs; después, alinear canonical, sitemap, enlaces internos y respuesta HTTP.
Paginación y descubrimiento de avisos
“Cargar más” e infinite scroll pueden mejorar la interfaz, pero Googlebot no hace clic en botones como una persona. Cada tramo de resultados que deba rastrearse necesita una URL propia y enlaces HTML rastreables con un atributo href válido. Google también indica que cada página de una secuencia paginada debería tener su propia canonical, en lugar de canonizar todas a la primera.
En la práctica:
- enlazá las páginas de resultados de forma secuencial;
- mantené URLs diferentes para cada página, sin fragmentos
#como identificador de paginación; - hacé que los avisos aprobados puedan encontrarse desde una categoría, subcategoría o landing;
- reservá el buscador interno para explorar, no como única vía de descubrimiento;
- incluí en sitemaps solo URLs canónicas que realmente querés indexar.
Para profundizar la relación entre jerarquías y enlaces, podés revisar esta guía de arquitectura web SEO.
Qué hacer con avisos vendidos, vencidos o eliminados
En C2C, la baja no es una excepción: es parte del ciclo de vida. La respuesta correcta depende de lo que queda en la URL.
- Mantener temporalmente: si la página conserva una descripción útil, aclara que el aviso ya no está disponible y ofrece alternativas relevantes sin engañar. Debe revisarse si esa utilidad justifica seguir indexándola.
- Devolver 404 o 410: si el contenido fue eliminado y no existe un reemplazo equivalente. Google deja de usar con el tiempo las URLs que responden con códigos 4xx.
- Redirigir: solo si hay una publicación o landing que sustituye de verdad a la anterior. Enviar cada baja a la home o a una categoría amplia confunde al usuario y puede ser interpretado como una respuesta de baja calidad.
- Evitar el soft 404: una plantilla vacía que devuelve
200no conserva valor por mantener el código de éxito.
El cambio debe reflejarse en todo el sistema: retirar la URL del sitemap, actualizar enlaces internos, cambiar datos estructurados y evitar que módulos de recomendación sigan presentando el aviso como disponible.
Datos estructurados para publicaciones C2C
Product puede ayudar a Google a entender una página de producto y habilitar presentaciones enriquecidas, pero el marcado tiene que representar lo que el usuario ve. Google distingue entre product snippets, para páginas donde no se compra directamente, y merchant listings, para páginas donde la compra puede realizarse.
Antes de implementar schema de forma masiva, definí el rol de la plataforma en la transacción. Un clasificado que solo conecta comprador y vendedor no debería copiar sin revisión el marcado de una tienda con checkout. Cuando corresponda, mantené sincronizados nombre, imagen, precio, moneda, disponibilidad y condición del artículo. El schema no corrige un aviso incompleto, no garantiza un resultado enriquecido y no debería declarar una oferta activa cuando la publicación ya venció.
Sitemaps y monitoreo por cohortes
Un sitemap de marketplace no debería funcionar como inventario de todas las URLs creadas. Debe listar las canónicas que se pretende indexar. Si el volumen lo justifica, separá publicaciones activas, categorías y landings facetadas en sitemaps distintos; así podés comparar enviados e indexados por tipo sin mezclar problemas.
Para diagnosticar, cruzá cuatro fuentes:
- Base de datos: estado real, fecha de alta, moderación, calidad y baja.
- Logs del servidor: qué patrones rastrea Googlebot y cuánto esfuerzo se concentra en facetas.
- Search Console: indexación, sitemaps, inspecciones y rendimiento por plantilla o directorio.
- Crawler propio: códigos HTTP, canonicals, directivas, profundidad, paginación y enlaces rotos.
No uses como KPI principal “cantidad de páginas indexadas”. Medí la proporción de avisos aprobados que Google descubre, la demora de descubrimiento, el rastreo desperdiciado en parámetros, la persistencia de URLs dadas de baja y el rendimiento orgánico por tipo de página. Si necesitás ampliar este diagnóstico, esta guía explica el crawl budget y su relación con la indexación.
Plan de implementación en seis pasos
- Inventariá plantillas y estados. Publicación, perfil, categoría, ubicación, búsqueda, faceta, paginación y baja deben tener una respuesta SEO definida.
- Construí una matriz de reglas. Para cada estado, documentá código HTTP, robots, canonical, inclusión en sitemap y enlaces.
- Separá facetas de navegación y landings. Elegí las combinaciones indexables; no dejes que cada selección de interfaz cree una landing orgánica.
- Integrá calidad y reputación. La aprobación editorial debe controlar cuándo una publicación pasa de
noindexa indexable. - Hacé rastreable la oferta aprobada. Usá enlaces HTML y paginación accesible; el sitemap queda como apoyo.
- Automatizá el ciclo de baja y auditá. Venta, vencimiento, moderación y eliminación tienen que actualizar señales técnicas sin contradicciones.
La prioridad no es maximizar URLs, sino sostener un índice coherente con la oferta real. En un marketplace C2C sano, una publicación se indexa porque superó un estándar; una faceta existe como landing porque responde a una demanda; y una baja deja de consumir rastreo cuando ya no aporta una respuesta útil.
Fuentes técnicas consultadas
- Google Crawling Infrastructure: gestión del rastreo de URLs de navegación facetada.
- Google Search Central: prevención de spam generado por usuarios.
- Google Search Central: estructura y navegación de sitios ecommerce.
- Google Search Central: paginación, carga incremental e infinite scroll.
- Google Search Central: uso de la directiva noindex.
- Google Search Central: canonicalización y contenido duplicado.
- Google Crawling Infrastructure: efectos de los códigos HTTP.
- Google Search Central: datos estructurados Product.
- Google Search Central: creación y envío de sitemaps.